入门层 · 第 1 / 25 课
Token:模型眼里的文字
学完这课你能
- 理解模型不认识文字,只认识 token id:一切文本进入模型前先变成整数序列。
- 理解 BPE「从字符开始、反复合并最高频相邻对」的原理,能手工在纸面例子上走两轮合并。
- 能解释为什么同一段中文在 GPT-2 词表下 token 数暴涨(无 CJK 词条 → 汉字裂成 3 个字节碎片)。
想象一条橙色长彩带:切刀「咔」一下一下,把它切成整齐的小段。模型读文字前也先来这么一刀——切得匀不匀,直接决定模型贵不贵。
01模型怎么「读」字
你读这句话用眼睛,模型读这句话用数字。它不认识「字」,只认识整数——神经网络张嘴吃的,永远是一个整数序列。所以任何文本进模型之前,都得先过一道「翻译」工序:把字符串切成小段,每段配一个编号。这道工序叫分词(tokenization),切出来的每段叫 token,配的编号叫 token id。
先别急着觉得这只是技术细节。切法决定了模型的「世界观」:一个词要花几个 token 才表示得完?遇到没见过的字慌不慌?处理一段中文要比英文多掏几倍钱?这些账,全在这一刀一刀里。往下看。
02两个笨方案
想自己切切看?你大概会想到两个起点。
第一个:按字符切,一个字母一段。好处是词表极小——几十个字母加符号就够,任何新词都不怕;坏处是序列被拉得老长,而且每个单元携带的信息薄得像纸——模型得自己费劲从「l」「o」「v」「e」四个字母里拼出「love」的意思。序列越长,计算越贵,学习越难。
第二个:按词切,一段一个完整的词,信息密度高;代价是词表爆炸——英语有几十万个词形,还有新造的词、人名、代码……更致命的是,遇到词表里没有的词(OOV,out-of-vocabulary)就当场抓瞎。两个方案都不行,我们需要折中。
03BPE:高频对合并
主流方案叫 BPE(Byte Pair Encoding,字节对编码)。听名字唬人,核心动作其实只有一句话:从单个字符出发,反复找出语料里出现次数最多的相邻符号对,把它们合并成一个新符号。一遍遍「数格子、拼积木」而已——拆得到最小颗粒,也拼得回大块,就像下面这盒乐高。
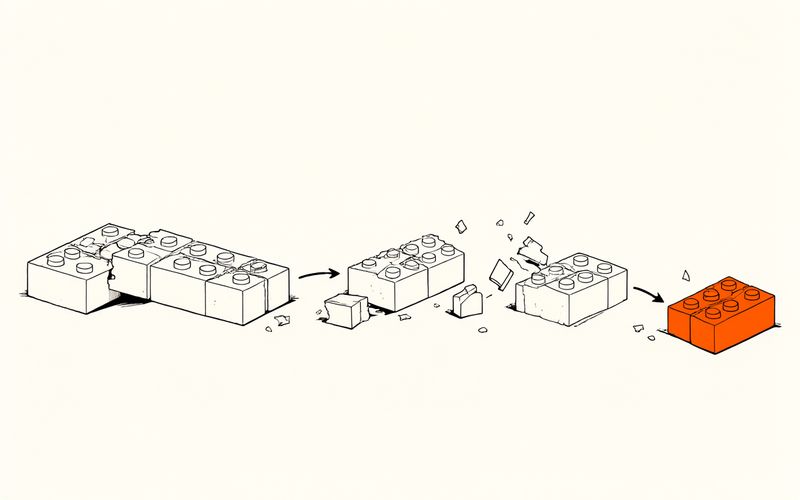
拿玩具语料走一遍。假设「low」「lower」「lowest」反复出现:第一轮统计,发现「l」+「o」这对邻居出现得最多——合并,造出新符号「lo」;下一轮,「lo」+「w」成了最常见组合——合并,得到「low」;再往后轮到「er」「est」。合并到什么时候停?取决于你想要的词表大小——常用的词停在这里,生僻的词保持字符状态。
切分的时候把这套流程倒着放:按合并的先后顺序(rank,越早合并优先级越高),把文本里的相邻对一路合并回去,直到没有可合并的对。每次合并的顺序被存进词表文件,这就是 tokenizer 数据的主体。
04词表大小意味着什么
词表大小是 tokenizer 最重要的参数,先记住三个量级:Qwen2.5 约 152064 个 token,GPT-2 是 50257,中文 BERT 是 21128。为什么不能随手定个大数?因为它直接牵动模型体积——模型第一层是一张「词表行数 × 向量维度」的查询表(下节课讲),词表翻倍,这张表就翻倍。
05中文的「名场面」
GPT-2 的词表里几乎没有汉字词条。于是一个「中」字进来,只能按 UTF-8 编码拆成 3 个字节,每个字节当独立 token——一个汉字裂成 3 个碎片。同一段中文,在 Qwen 词表下大约一字一 token,在 GPT-2 词表下 token 数直接翻三倍左右。
这就是「为什么早期国外模型的中文 API 更贵」的直观原因:计费按 token 走,而坏 tokenizer 给中文多收了两倍的税。想亲手量出这笔税?下面的演示器就是为你准备的。
06字节级兜底
那生僻字、emoji、乱码怎么办?别急,现代 tokenizer 留了最后防线:字节。任何字符串在计算机里终究是字节序列,词表覆盖不到的字符退到字节级也能切。保证任何输入都切得开、切不坏——这也是为什么你往对话框里贴天书,模型也不会报错。不信?在下面演示器里点一个生僻字,亲眼看这条兜底路径被触发。
交互实验:BPE 双词表切分演示器
引擎加载中…
输入任意文本,左面板按 Qwen 精简词表、右面板按 GPT-2 词表现场切分,逐 token 着色并给出 id 与字节数。切分由你的浏览器本地计算,不联网、不上传。
组件加载中…(BPE 双词表切分演示器需要 JavaScript)
组件加载失败。
降级方案:在线词表加载失败时,组件会退到内置演示词表(256 个字节 token 为底、外加少量高频合并规则,统计非真实),输入框仍可玩,状态栏会标注「演示数据」;页面不会白屏,图文正文不受影响。