解剖层 · 第 7 / 25 课
FFN:词与词之间的知识仓库
学完这课你能
- 理解 FFN 是逐 token 独立的两层 MLP(token 之间不交流),与注意力分工:注意力传话、FFN 加工。
- 理解为什么需要 GELU 这类非线性激活(没有它两层矩阵乘等价一层)。
- 知道 FFN 占参数大头、「FFN 存知识」假说,以及激活的稀疏性。
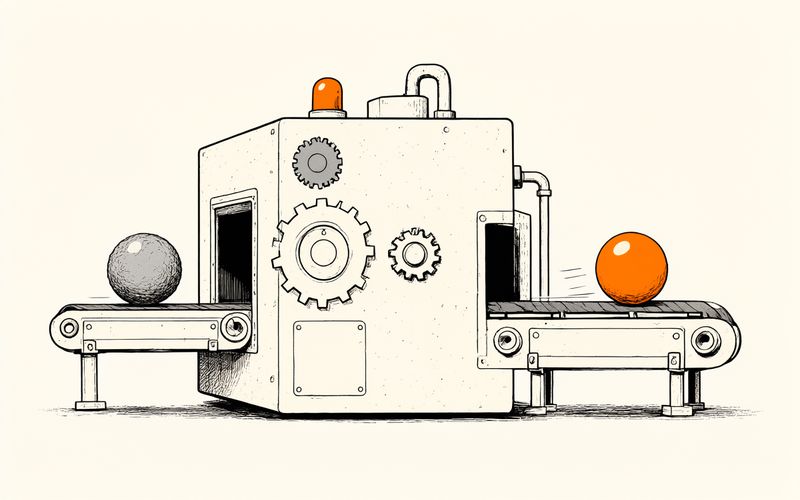
想象一间加工车间:毛坯从左边传送带进来,穿过一排机床,出门时已经锃亮上色。注意力负责把料搬到车间门口,FFN 就是里面那排机床。
01分工:一个管通信,一个管计算
拆开 transformer 的每一层,里面其实只有两个零件:上节课的注意力,和本课的主角 FFN(前馈网络,feed-forward network)。分工一句话就能记住:注意力负责传话——把别处的信息搬到当前位置;FFN 负责加工——对着搬来的信息埋头计算。
「埋头」是字面义:FFN 对每个 token 完全独立地做同样的变换,token 之间零交流。你在第 5 课热图里看到的密集连线,到了 FFN 这里,一格信息都不流动。
02结构账
pythia 的 FFN 是两层矩阵乘夹一个激活:128 维进,先升到 512 维(4 倍),激活后再压回 128 维。来算笔参数账:每层注意力约 6.6 万个参数,FFN 约 13.1 万个——单层就是两倍差距,6 层叠完,FFN 占的参数份额远超注意力。参数大头在哪,下面的图直接给你标出来了。
这就引出一个有意思的问题:模型的大部分「脑容量」,花在了一个不跟邻居交流的部件上。它在里面存什么?先记着这个问题。
03GELU:非线性的理由
中间夹的那个激活函数,存在感不强,作用却生死攸关。为什么?矩阵乘法是线性的:两层矩阵乘连着做,数学上等价于一层——不弯折,叠 100 层也白叠。在中间加一个非线性「弯折」(激活函数),层与层才真正有了区别,网络才有深度可言。
早期常用 ReLU(负数归零、正数放行),pythia 用更平滑的 GELU:负半轴不是一刀切零,而是 softly 押下去,像一道软门——大部分负输入被拦,少数小负数也能漏一点过。实验台里画着这条曲线,你的输入在曲线上是个会动的小圆点,去推推看。
04知识仓库假说
「FFN 存知识」是 interpretability 研究里的主流猜想。直觉版是这样的:第一层矩阵当 key 用——检测「当前语境是不是某种模式」(比如「首都」「法语相关」);第二层矩阵当 value 用——检测命中后,往残差流里写出相应内容(比如「Paris」方向的信息)。key 对上、value 写出——匹配模式、输出事实,一整套机制。
点到即止:这个假说有大量证据,也有反例。但它给了我们看 FFN 的正确姿势——不是黑盒,而是一柜子待触发的抽屉。
05稀疏性:谁被点亮
看真实激活你会发现:神经元是被「点名」的——对每个输入,少数神经元输出巨大的正值,绝大多数挤在 0 附近或小幅负值(GELU 软门把大部分单元拦在门外)。像一串串好的灯:少数几盏亮起,其余大多熄着——模型就用「少数抽屉的组合」表达特征。但先别把教科书结论当教条:pythia-14m 只是个 14M 小模型,稀疏程度不如大模型夸张——实验台的稀疏性读数会给你每一层的真实数字。
消融开关能让你亲手验证这件事的分量:把最亮的那个神经元置零,后续输出和最终预测立刻变脸;随手关一个接近 0 的,几乎无人察觉。重要与不重要,差距就这么直白。
交互实验:神经元激活观察台 + 消融开关
引擎加载中…
选句中一个 token、选一层,看它在 FFN 中间层的全部激活值热条(canvas 单行色带,亮 = 绝对值大,top-10 有刻度);hover/方向键查真值;GELU 曲线联动标注被选中神经元的前激活值;消融模式点神经元「置零」,现场从该层重算到底并对照 logits 变化 top5。
等待开始下载…
组件挂载点 · 激活观察台将在下一波接入(复用已加载权重)
组件加载失败。
处理方式:多为网络抖动或权重文件缺失——刷新页面,或在实验台里点「重试:下载并加载 pythia-14m 权重」。图文正文不受影响。