解剖层 · 第 10 / 25 课
残差流:128 维信息高速公路
学完这课你能
- 理解残差连接:每层只学「改动量」,x + f(x) 让信息与梯度都能直通深层。
- 理解 pythia 的 parallel residual(x + attn(x) + ffn(x))与 GPT-2 serial 残差的差异。
- 会用 logit lens(中途 hidden 先过最后一道 LayerNorm、再乘 lm_head)观察「预测是怎样一层层成形的」。
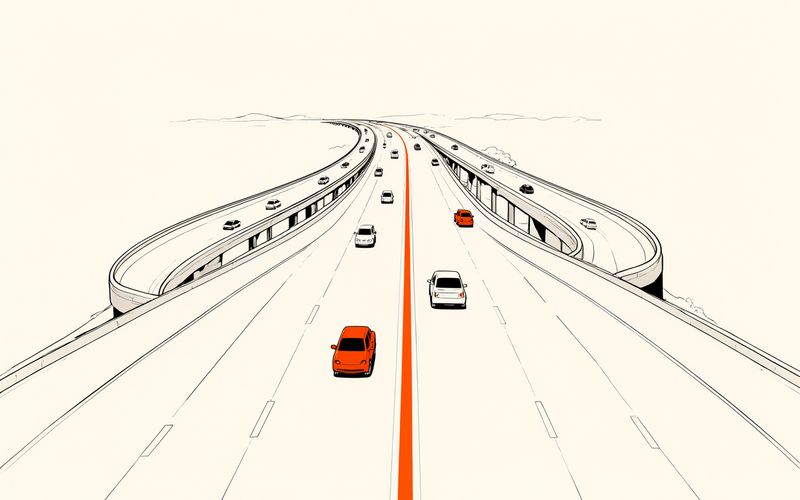
想象一条 128 车道的高速主干道:货物从起点直达终点,沿途每个服务区只往车上添自己的货。残差流,就是这条道。
01深网传话难题
先看一种练不动的网络:没有捷径,每一层都把上一层的输出整个重写一遍。信息要穿过 100 层,就得被完整转述 100 次——传话游戏的结局你猜得到。反向传播时更惨:梯度一路上层层缩放,到第一层基本听不见指令。深网曾经练不动,根源就在这。
transformer 的解法,你坐高速路时天天见:修一条主干道,让原始信息一路直达终点;每一层只是个小服务区——进来加点货,再放回主干。主干常在,每层只负责自己的贡献。
02残差 = x + f(x)
写出来就一行:每层的输出不是 f(x),而是 x + f(x)。这个加号就是「主干直通」——原始 x 原封不动流向下一层,f(x) 只是本次服务区加的货。为什么非要这样?你想:对「学改动量」比「学完整表示」容易得多——新层只需要学「还缺什么」,不必重学「已有的一切」。
反向传播时这个加号同样是捷径:梯度可以沿 x 的路径无衰减地直通浅层。残差连接(residual connection)因此是深层网络能练起来的第一功臣。
03serial vs parallel
服务区还能再分两种布局。GPT-2 是串行(serial):x 加上注意力的输出,得到中间结果,再过 FFN,再加回——两站排队。pythia(GPT-NeoX 系)是并行(parallel):注意力和 FFN 各自从同一份 x 出发(各自先过自己的 LN),两个输出同时加回 x。
并行的动机朴素:省掉一次「先过这站再过那站」的串行等待,训练效果与串行相近。咱们全程在跑的 pythia-14m 采用的正是并行残差;你会在第 11 课的结构图里再次见到这个布局,第 25 课的拼装台上还会亲手把它拼出来。
04残差流视角
换个角度看整只模型:那个从 embedding 一路加到输出的 128 维向量,是一条贯穿 6 层的总线——研究者称之为残差流(residual stream)。注意力和 FFN 都只是「往总线上写信息的模块」:注意力写「从别处搬来的」,FFN 写「本地加工出的」。整条总线长什么样?看这张剖面图。
谁写得多是可测的:比较每层两模块输出向量的范数占比,能看到浅层多靠注意力搬信息、某些层 FFN 写入更重。实验台会画出这条占比曲线,你亲眼去看。把高速换成大河也一样:干流从不封路,每条支流只负责把自己的水汇进来。
05logit lens:预测的成形过程
输出层的预测是「最后的 hidden 过 lm_head」算出来的。那中途的 hidden 呢?也把它提前送进 lm_head 看一眼——这招叫 logit lens。于是你能逐层偷看模型的「当前想法」:embedding 之后是乱猜,中间某层开始出现靠谱候选,到最后「The capital of France is → Paris」彻底成形。想亲手偷看?实验台的「升天之路」逐站摆给你。
这个收尾细节本来藏在引擎里:untied 的两份查询表、过 LN 再出成绩——实验台的「升天之路」把这些站点全摆出来给你逐站检阅,页尾还有对拍自检。
交互实验:一个 token 的升天之路
引擎加载中…
输入短句(≤14 token)→ 点选要追踪的 token(默认最后一个)→ 七个站点(embedding → 6 层输出)逐站点亮(≤2 秒,「减少动态」时直接完整展示):每站画出该 token hidden 的 128 维分量色带(跨站同一色标,看条带演化)与范数;同时用 logit lens 偷看它的「当前想法」——每站 hidden 先过 final LayerNorm 再乘 embed_out,取 top5 预测逐站排开,看预测从胡言乱语逐层成形。页尾自检:第 7 站 lens 与引擎真实 logits 对拍。14M 小模型能力有限,最终答案未必如教科书般漂亮——预测随层数越变越靠谱才是本课要看的。
等待开始下载…
组件挂载点 · 升天之路将在下一波接入(复用已加载权重)
组件加载失败。
降级方案:权重下载或加载失败时显示「加载失败,点击重试」,不白屏,图文正文不受影响。