锻造层 · 第 13 / 25 课 · 训练的发动机
梯度与反向传播:浏览器里真训一只模型
学完这课你能
- 说清梯度=「往哪边调、调多少」的方向指示:把某颗参数拨动一丝,loss 变多少。
- 理解反向传播=责任从 loss 沿网络逆着层级分摊回每个参数,一次过网、全梯度到手。
- 亲手在浏览器里训一只字符级微模型,亲眼看 loss 下降、生成从乱码到成形。
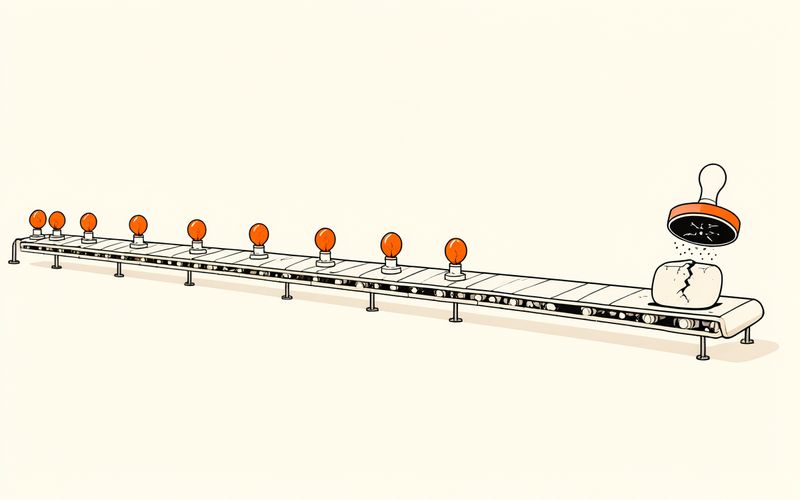
一座流水线工厂:成品在末端被盖了「不合格」的章。要追责,红灯不会只亮在最后一站——它会沿着传送带逆流而上,从末端到起点逐盏亮起,每道工序都拿到自己的那份责任。反向传播,就是这条逆流的红灯。
01训练闭环的最后一环
上一课你把判分玩明白了:loss 回答「差多少」。但闭环还差最后一环——谁来改权重?怎么改?总不能拿着记分牌干瞪眼。这一环叫反向传播(backpropagation),它是所有深度学习框架的发动机,也是你这一课要亲手拧的钥匙。
拆成两步看:先搞懂「每颗参数该往哪边挪多少」(梯度),再看「怎么一次算出所有参数的梯度」(反向传播)。
02梯度:每颗参数的「悔意」
白话版偏导数:把某一颗参数轻轻拨动一丝,重新判一次分,看 loss 变多还是变少——「变多少」就是这颗参数的梯度。loss 涨了,说明这颗参数在帮倒忙,该往回退;loss 降了,说明它立了功,可以再进一步。所以负梯度方向 = 让 loss 变小的方向,每颗参数的梯度就是它的「悔意」:悔意越大,越该大步改。
麻烦在于:一只模型有几万颗参数(本课的微模型 3.5 万,pythia 是 1400 万),挨个拨动试loss,要试几万次。得有个聪明的算法。
03反向传播:一次算清所有悔意
聪明的算法靠一条直觉:最后一层最先知错,然后错误信号乘着各道工序的「传递系数」逐层往前传。输出层拿到「差多少」,算完自己的账,把责任按传给它的比例拆给上一层;上一层拿到责任,再算自己的账,继续往前拆——一层过一遍,从 loss 走回 embedding,所有参数的悔意同时到手。这不是数学课,你只需要记住「责任逆流」这个画面。
整条链路一张图看完:
04亲手训一只
下面是一只货真价实的字符级 mini-GPT:2 层、1 个注意力头、模型维度 32、上下文 16 个字符,词表就是语料里出现过的字符(唐诗语料 285 个字符),一共 3.5 万参数。forward + backward 全部手写 JavaScript,没有任何预录数字——你按下开训,loss 掉下来,是你的 CPU 刚刚真的在算。同一 seed 完全可复现,重置按钮旁边标着它。
05乱码到成形
训练时它每 50 步交一次作业(自动采样一段续写)。头几十步的作业是纯乱码——随机权重只会说随机话。一百步之后开始有字的组合规律,两百步上下你能认出「像诗的句子」了。能力就是这样一棱一棱长出来的,第 16 课的快照动物园会让你把每个阶段掰开细看。
交互实验:微型训练器(浏览器现场真训练)
引擎加载中…
字符级 mini-GPT(2 层 × 1 头 × d32 × ctx16,约 3.5 万参数)在你的浏览器里现场训练:forward + backward 全手写 JS、零依赖、无任何预录数字。训练按帧分片跑,UI 不冻结、随时可暂停;同一 seed 完全可复现。默认超参 lr 0.1 + momentum 0.9 + batch 16,与引擎内置验收配置一致(300 步滑动平均约 5.28 → 0.67)。
组件加载中…(微型训练器需要 JavaScript;正文不受影响)
组件加载失败。
降级方案:自动切换「离线训练实录」回放(assets/data/phase2/l13-train-traj.json.gz,同一训练器在 node 里真跑导出,seed 42)——曲线与采样照常播放,角标变为「回放」,并如实标注非现场计算。