锻造层 · 第 16 / 25 课 · 锻造层收官
检查点与训练轨迹:模型成长相册
学完这课你能
- 理解检查点=训练中途给权重拍的快照,保存的是「那一刻的模型」。
- 通过同一只模型不同阶段的输出对照,建立「能力是逐步长出来的」的体感。
- 会读训练轨迹:loss 曲线连续下降,阶段性能力跳变却不是均匀发生的。
给同一棵树每月拍一张照,平日你盯着它看不出变化;把照片排成相册一翻,生长突然看得见了。模型的成长也一样——loss 天天在降,但只有翻快照,你才看得见它「学会了什么」。
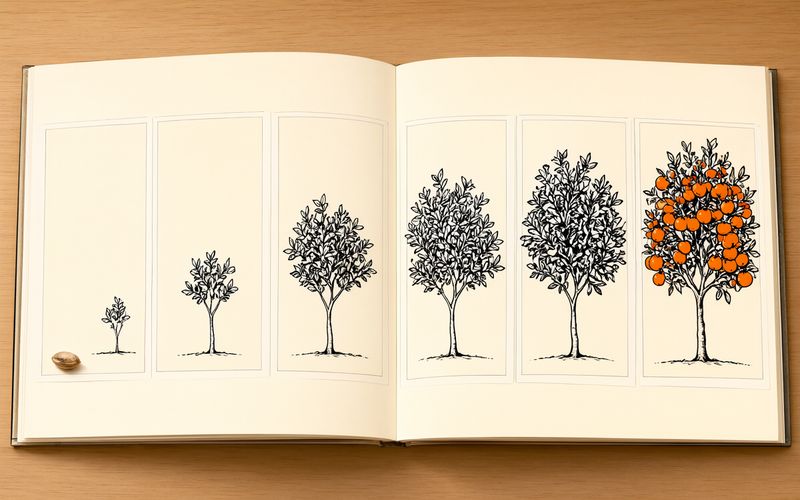
01训练要留档
训练一跑几天几周,不存档等于裸奔:断电要能从最近一步续训(断点续训)、想知道哪一刻的模型最好用要能回头挑(选最佳)、想研究「能力什么时候长出来」更要有一排不同时刻的权重(研究演化)。所以训练器每隔一段就把当时的全部参数存一份——这份存档叫检查点(checkpoint)。
这不是课堂里编出来的概念:你正在用的 pythia-14m,官方就公开了一整排中途检查点(step1000 一直到 step143000,每隔一千步一档,另加 11 个更早的起步档)——整部公开的成长相册。
02快照动物园
下面是你亲手在上一课训过的那种微模型(唐诗语料、3.5 万参数、300 步)留下的6 档快照:step 0 / 60 / 120 / 180 / 240 / 300,每档都保存着完整权重数值。拖动时间轴,每一档都在浏览器里现场真前向生成给你看——不是录好的文案,是那一刻的权重真的在你机器上算。
同一句「床前明月」,六个年龄的模型会接出六种答案。
03同一个问题的三个年龄
挑三个档位并排读:step 0 的答案是从随机数里捞出来的纯乱码;step 120 的答案开始有「字的组合规律」,逗号句号各就各位;step 300 的答案已经有了诗的骨架——「床前明月下问童子」,接得莫名其妙,但格式全对。能力不是某一天突然降临的,是沿着轨迹一棱一棱长出来的。
04训练轨迹全景
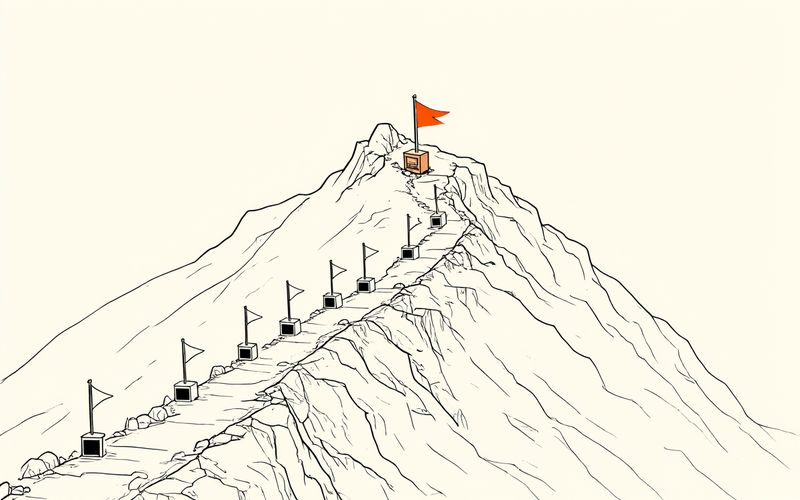
把 300 步的 loss 曲线完整播一遍:里程碑旗标正好插在曲线的拐弯处——陡降段对应「学会格式」,缓坡段对应「抠细节」。点任何一面旗,时间轴会跳到那一档快照,你可以立刻验证「那一刻它学会了什么」。这条曲线与第 12 课你看过的是同一条(同一只模型、同一次训练),那里看判分,这里看成长。
05相册的尽头
相册翻到最后,回头看:解剖层里你拆开的每一颗权重——注意力的 QKV、FFN 的两层、LayerNorm 的刻度——都是这样从随机数一步步长成的。第 13 课你按下开训那一刻看到的乱码作业,就是这颗权重的婴儿照。锻造层到这里收工:模型怎么被练出来,你已经从头到尾亲手跑了一遍。
交互实验:快照动物园 + 训练轨迹回放
引擎加载中…
动物园数据来自 assets/data/phase2/l16-zoo.json.gz(tools/study-phase2/gen-zoo.mjs 离线真跑,seed 42,2026-10-13;含 6 快照完整权重 + 300 步轨迹 + 里程碑实录,约 290KB,进本实验区才加载)。选中档位的生成由快照权重在浏览器内现场前向(角标「真计算」);轨迹回放与离线实录文本为预计算数据(角标「回放」),其生成脚本、种子与日期见包内 meta。
组件加载中…(快照动物园需要 JavaScript;正文不受影响)
组件加载失败。
降级方案:快照包加载失败时,展示离线实录文本对照(同一次真实训练导出,角标变「回放」);轨迹曲线以内置降采样继续回放。图文正文不受影响。