发力层 · 第 21 / 25 课 · 把模型跑起来
采样实验室完全体
学完这课你能
- 说清四大旋钮各自拧什么:温度改分布陡峭度、top-k 砍长尾、top-p 按累计质量砍尾巴、重复惩罚压旧词。
- 用四配置并行对照读出策略差异:同一句 prompt,四种口味一眼分晓。
- 建立边界感:解码策略不改模型,只改「怎么用模型给出的分布」。
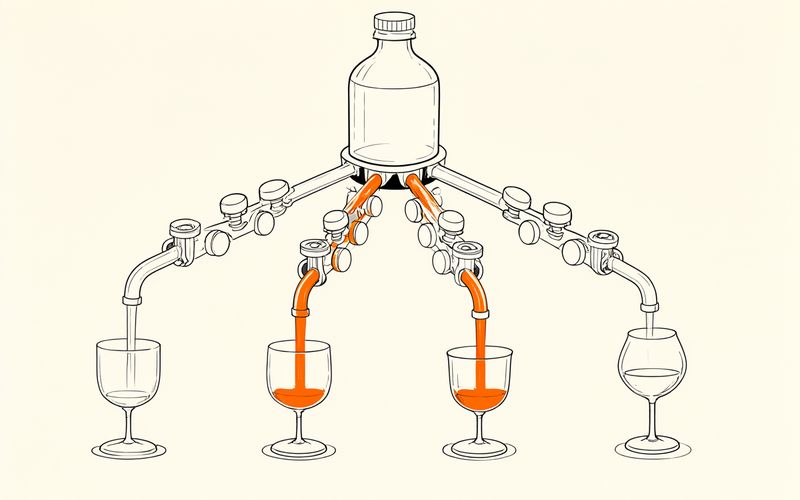
同一壶基酒,四个调酒师各拧各的旋钮:一杯纹丝不动,一杯温润标准,一杯烈得呛喉,一滴酒都不重复。模型的采样台长得一模一样——基酒是同一份概率分布,风味全看旋钮。
01回收第 4 课的伏笔
第 4 课说过:每生成一个 token,模型先给出全词表 50304 个分数(logits),再从里面「选一个」。当时你手里只有温度一个旋钮,top-k 露了一脸,剩下的全部许诺到了这节课。现在承诺兑现:完整的采样流水线一共四道工序,一个不少。
先立一块界碑:这一整课,模型的权重一个数都不动。四个旋钮拧的都不是模型,而是「怎么用模型给出的分布」——同样的 prompt、同样的权重,采样配置一换,文风就换。这就是「解码策略」四个字的全部含义。
02四个旋钮各管什么
按流水线顺序过一遍。先上重复惩罚:生成过程中已经出现过的 token,把它们的分数往下压一压(正分除以 α、非正分乘以 α),专治复读机。第二道温度:分数整体除以一个 0.1–2.0 的数——低温把分布削尖,模型保守;高温把分布摊平,模型放飞。第三道top-k:只留分数最大的 k 个候选,长尾一刀砍掉。第四道top-p:按概率从大到小累加,累加到刚好 ≥ p 就收手,剩下的尾巴整段砍掉——候选数量随分布形状自动伸缩,所以也叫「核采样(nucleus)」。
03四联屏对照
下面这台实验台给你四列互不干扰的采样器,默认分别是四种经典配置:贪婪(t≈0,永远选最大)、均衡(日常手感)、狂野(高温宽口)、禁重复(惩罚拉满)。同一句 prompt,一键四列同跑——都是 pythia 真权重、真采样,差异全部来自旋钮。
看的时候盯两处:一是第一句分岔点——四列从第几个 token 开始走向不同;二是崩溃方式——贪婪列容易车轱辘话,狂野列容易飞出句子,各有各的死法。
04抽卡手感
重复惩罚值得单独玩一把:让模型重复一个短语(比如把 prompt 写成 Banana banana banana),普通的均衡配置多半接着 banana 到底;把 α 拉到 1.5 以上再看——被抽烂的那张卡被硬生生挤出候选,模型只能换词。这就是「压旧词」的手感。
05什么场合拧什么钮
收尾一张速查表,都是社区经验不是铁律:代码生成要温度贴近 0——一个字符都不能赌;文案创意温度 0.9 上下,放飞一点才有人味;摘要翻译把 top-p 收小(0.8 以内),少让长尾搅局;一旦看见复读,先加重复惩罚再调别的。下一次你拧任何一个 API 的采样参数,背后过的都是这条流水线。
交互实验:四联屏采样实验室
引擎加载中…
同一句 prompt 四列并行:每列温度 / top-k / top-p / 重复惩罚四滑杆 + 预设 chip(贪婪 / 均衡 / 狂野 / 禁重复),可四列同跑或单列跑,每步保留 top-5 概率快照。真权重、真采样,全部在你的浏览器里算。
等待开始下载…
组件加载中…(四联屏采样实验室需要 JavaScript)
组件加载失败。
处理方式:多为网络抖动或权重文件缺失——刷新页面,或先玩下方不依赖权重的「参数沙盘」,图文正文不受影响。