发力层 · 第 23 / 25 课 · 把模型跑起来
量化:给模型瘦身
学完这课你能
- 说清对称量化的完整动作:找绝对值最大值定缩放因子 → 取整到整数码 → 反量化近似还原。
- 现场量化 pythia 真权重并对比:体积 28→14→7MB 三级台阶,logits 走样多少当场见分晓。
- 建立「精度-体积-质量」三角的体感:int8 常常无感,int4 开始口音变重。
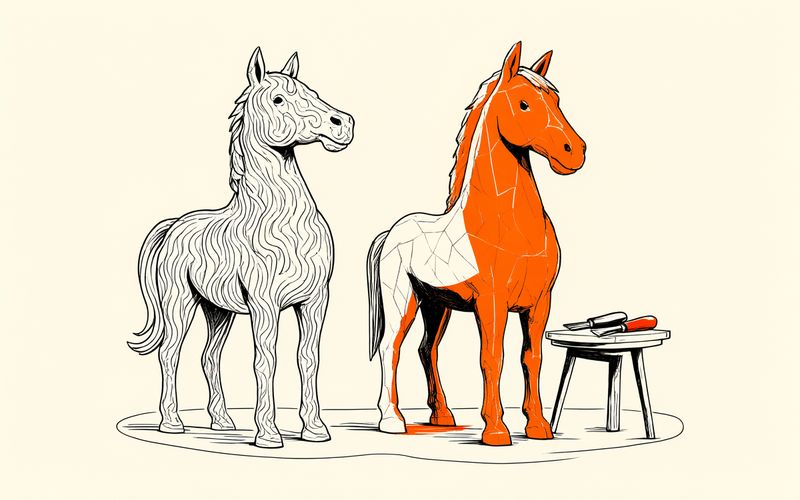
同一匹木马:精雕版毛发根根分明,粗刻版三五刀就出形——远看几乎一样,近看刻痕完全不同,行李箱里粗刻版只占精雕版一半的地。量化就是给模型换粗刻刀。
01为什么要瘦身
先看账本:pythia-14m 的 fp16 权重 28.1MB,你已经在浏览器里下过一次了。乘到工业级:7B 模型 fp16 要 14GB 起步——一张消费级显卡勉强塞下,手机想都别想;要是做成网页服务,每个访客的下载和显存都是真金白银。而模型的权重,恰恰是出了名的「远看够用」:大多数数值挤在很窄的范围里,小数点后第很多位的精度,经常用不上。能不能把刻刀换粗一点?
02量化四步
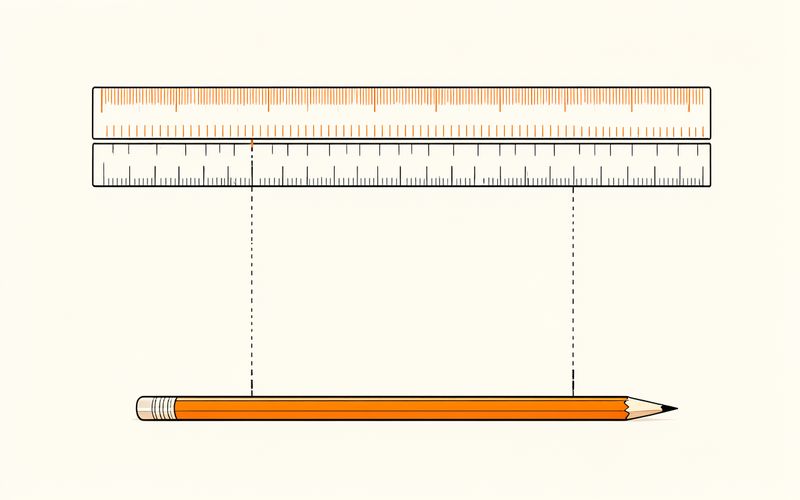
对称量化的完整动作只有四步:①在一块权重里找绝对值最大的那个数;②定缩放因子 scale = max|w| ÷ 127——这一步等于把整块权重的取值范围摊到 256 个整数格点上;③每个权重除以 scale 再四舍五入,落进最近的格点,存成整数(int8 每颗 1 字节,int4 每颗半字节);④用的时候乘回 scale,得到近似原值的 fp32 数。格点越密(int8 的 256 格 vs int4 的 16 格),近似越贴;格点越疏,体积越小、走样越多。
「一块」怎么划也有讲究:整层张量共用一个 scale 叫 per-tensor,最粗;每行(每个输出通道)各自一个 scale 叫 per-channel;再细的还可以每 32 个数一块(per-block,本课实验台的默认档,GGUF 的 Q8_0 就是这个思路)。块越小,scale 越贴身,走样越小——但元数据也越多。
03现场量化真权重
实验台把这套动作在你浏览器里原地上演:以 fp16 权重跑一遍当基准,再一键把全部 2D 权重矩阵砍成 int8 或 int4(1D 的 LayerNorm 和 bias 保持 fp32,业界惯例,它们只占 0.08% 参数),反量化后用同一句 prompt 再前向一遍。三样对照当场出:top-5 候选重合率、top-1 有没有翻车、240 个抽样 logits 的散点图。全都是你的 CPU 现场算的,不是查表。
04体积账
体积账用真实张量字节数求和:14,067,712 颗参数,fp16 每颗 2 字节 = 28.1MB;int8 每颗 1 字节 = 14.1MB;int4 每颗理论 0.5 字节 = 7.0MB(账面值——实际文件还得加上 scale 这类元数据)。三级台阶在实验台的条形图里一眼见分晓。
05什么时候敢用量化
一线部署的经验一句话版:int8 常常无感,可以放心当默认;int4 要挑方案——分组、per-channel、混合精度保住关键层,否则质量下滑会从「口音」变成「跑调」。还有一条本课没演但值得知道:量化后的模型也可以再量化感知训练(QAT)练回来。下一课是毕业课:把分词、prefill、cache、decode、采样、量化拼成完整推理栈,给整门课收口。
交互实验:现场量化台
引擎加载中…
fp16 基线 → int8 / int4 一键切换(粒度 per-block(32/16) 可换 per-channel / per-tensor),量化、反量化、前向全部现场真算(真权重 + 真计算);top-5 重合率、top-1 翻转、logits 散点、体积三级台阶实时对照。
等待开始下载…
组件加载中…(现场量化台需要 JavaScript)
组件加载失败。
处理方式:多为网络抖动或权重文件缺失——刷新页面,或看下方「导出机对照回放」,图文正文不受影响。