入门层 · 第 4 / 25 课
自回归生成:一个词一个词往下写
学完这课你能
- 理解生成 = 「预测 → 追加 → 再预测」的自回归循环,GPT 的 G 就来自这里。
- 理解上下文窗口:模型一次只能看窗口内的 token,pythia 为 2048。
- 初识 temperature:同一个模型,「稳」和「飘」只差一个采样参数(发力层伏笔)。
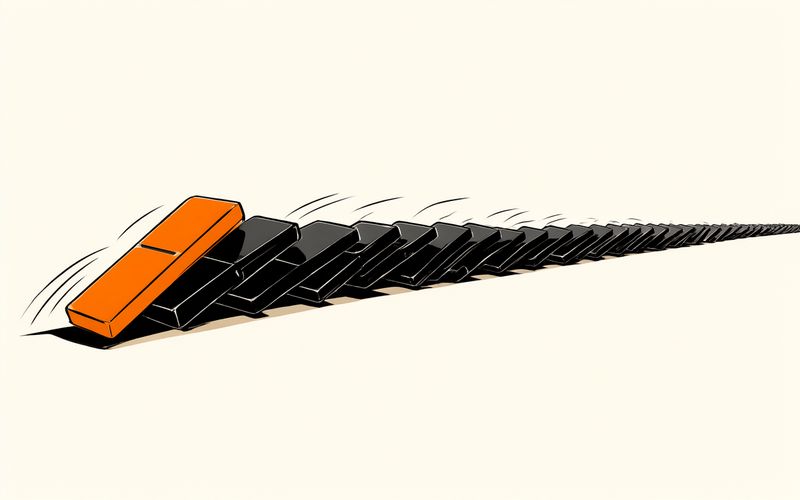
推倒第一块多米诺,剩下的链条自己一块接一块倒下去——每一块都由上一块触发。模型写长文就是这个玩法:写出一个词,拼回输入,再写下一个。
01G = Generative
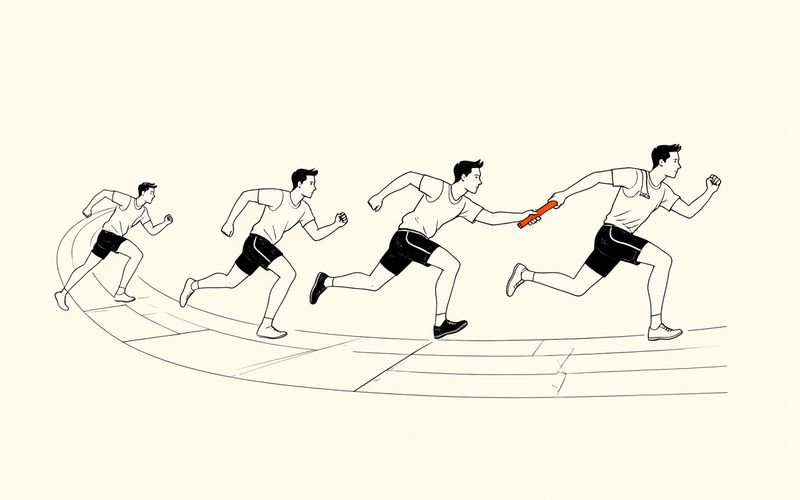
上节课说了,模型每一步只多预测一个词。那长文章从哪来?答案是一个朴素得近乎笨拙的循环:把开头喂进去 → 拿到概率分布 → 选出一个 token → 拼回输入末尾 → 再喂进去 → 再选一个……如此往复。这叫自回归(autoregression)——自己的输出回头当自己的输入,像接力赛一棒交给一棒。
GPT 的 G 就是 Generative:它生成的方式和你用输入法打字差不多,只是每个字都出自它自己刚算出的分布。「模型写的每个字,都是它当时算出的概率分布里抽的」——这句话值得念两遍。循环长什么样?画出来是这样:
02上下文窗口
循环每转一圈,输入都变长一点。但模型一次能看的长度有上限,叫上下文窗口——pythia 是 2048 个 token。超出窗口怎么办?要么把最老的截掉,要么让窗口往前滑。于是有一个扎心的事实:模型天生「没有记忆」。你以为它记得三页之前的话,其实那些 token 早被丢出窗外了——它看得见的,只有窗口里的。
为什么会有窗口上限?和模型怎么知道词的顺序有关——这条伏笔第 9 课(位置编码)回收。
03为什么生成会跑偏
自回归有个内在缺陷:每一步的小错误会被自己吃进去,成为下一步的「事实」。第 20 个词选偏了,后面全部建立在偏掉的地基上,越写越歪。为什么会这样?训练时模型看到的是人类写的正确前文,生成时看的却是自己写的前文——两种处境的落差,是跑偏的根源(exposure bias 的直觉版)。
模型越小,单步错误率越高,滚雪球越明显。所以小模型往往前半句通顺、后半句开始说梦话。
04采样第一课
每步拿到概率分布后,「选哪个 token」是一类药物:永远选最大的是 greedy,稳但容易复读车轱辘话;按概率随机抽是采样,鲜活但可能离谱。在两者之间拧动的是 temperature(温度):低温把分布削尖、输出保守,高温把分布摊平、输出放飞。
本课的实验台给你 temperature 滑杆——亲手感受同一个模型「稳」与「飘」的两副面孔。完整的解码策略家族(top-k、top-p 等)留到发力层系统讲。
05小模型会胡说
提前打个预防针:14M 参数的 pythia 是在 The Pile 语料上训练的——那是一份网页文本大杂烩,装不下多少可靠的事实知识。让它聊现实话题,它会一本正经地胡说——这不是页面坏了,而是小模型真实的能力边界。相对顺手的反而是虚构故事体:以 Once upon a time 开头,它接得头头是道。
顺带记住这个体感:模型「会说话」不等于「说的对」。大模型的幻觉,是同一个现象的放大版。
交互实验:生成实验室
引擎加载中…
prompt 输入框(默认 Once upon a time)+ max tokens / temperature 滑杆,打字机式逐 token 生成,可展开每步 top-5 概率快照,可一键 A/B 对比低温与高温。生成全程在你的浏览器里算。
等待开始下载…
组件加载中…(生成实验室需要 JavaScript;复用第 3 课已加载的权重)
组件加载失败。
降级方案:权重复用第 3 课的会话缓存,未加载时首次点击才下载;下载或加载失败时显示错误卡与重试提示,不白屏,图文正文不受影响。