解剖层 · 第 5 / 25 课 · 开始拆黑盒
注意力:让每个词看向别的词
学完这课你能
- 理解注意力解决什么:一词多义与指代——每个 token 按需从别的 token 收集信息。
- 掌握三步计算:score = QK^T/√d → causal mask → softmax 加权求和 V;知道每步矩阵的形状。
- 会读注意力热图:行 = query 位置、列 = key 位置、深色 = 权重大(bertviz 范式)。
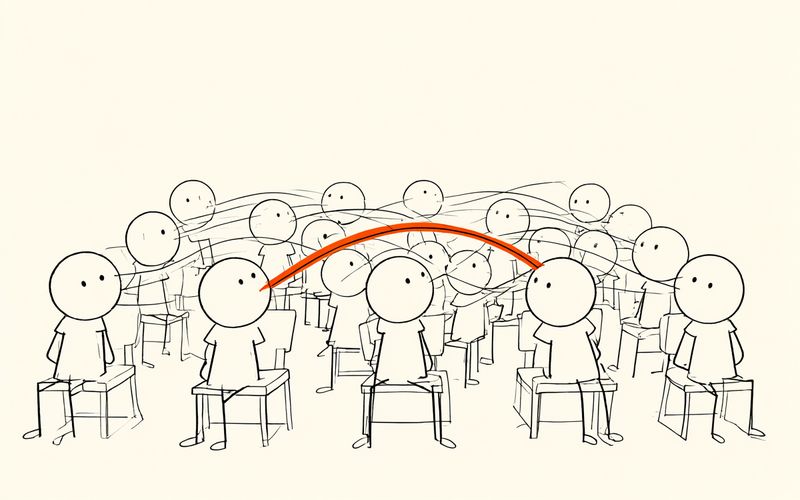
先看一幅画:一间教室,几十个学生互相扭头张望,视线在空中织成一张网——其中一条橙线特别粗,那是全场最上心的一眼。注意力机制,讲的就是这间教室。
01「它」指谁
「猫追老鼠,它跑得很快。」——这个「它」是猫还是老鼠?先别急着回答。注意你刚才干了什么:你回头看了一遍上下文,就这一眼,完成了消歧。上节课结尾埋的静态向量问题(bank 又是银行又是河岸)也是同一类病:一个位置要确定自己「此刻」的意思,必须去别的位置收集信息。
transformer 里干这件事的机制叫注意力(attention)。名字有点玄,做的事很朴素:让每个 token 按需看别的 token,看谁有用就多拿谁的。怎么看、拿多少?往下走。
02一句话版注意力
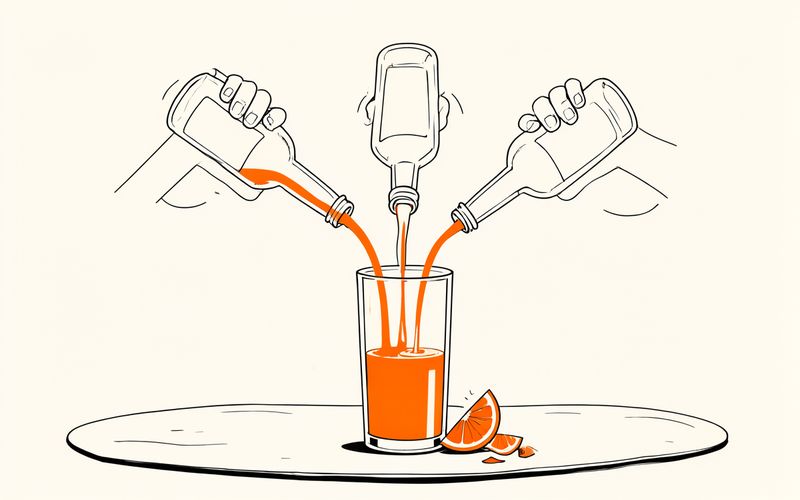
每个 token 会生成三样东西:query(我在找什么)、key(我这里有什么)、value(我能提供的内容)。你可以把每只 token 想成举着一张「寻找卡」和一张「招牌卡」的人:拿自己的 query 去和所有人的 key 对暗号,匹配度高的,就多搬回它的 value——像不像调酒师勾酒?按对暗号的浓淡决定各家倒多少,比例抓得越准,这杯越对味。
于是「它」这个位置的输出,可能大半来自「猫」。注意到了吗?信息完成了跨位置的流动,一词多义在表示层面被消解——这正是你回头看的那一眼。
03三步计算拆解
写成算式只有三步,你跟着走一遍。第一步,三个投影矩阵 Wq、Wk、Wv 把每个位置的向量分别乘成 Q、K、V(pythia 里都是 128×128 的矩阵,带 bias)。第二步,Q 乘 K 的转置,得到一个「句子长度 × 句子长度」的打分矩阵——第 i 行第 j 格,就是「位置 i 对位置 j 的兴趣分」。这个分数要先除以 √d(每头维度 32 就除 √32):维度越大点积天然越大,不缩放的话 softmax 会饱和成非黑即白。
第三步,对每一行做 softmax 变成权重,再按权重加权求和所有位置的 V。每行总和恒等于 1——这是 softmax 的性质,待会儿在热图里你可以亲自验。三路怎么汇合,看这张图。
04causal mask:不许偷看未来
生成模型有条铁律:预测第 i 个词时,只能看第 1 到 i−1 个词。怎么执行?简单粗暴——把打分矩阵的上三角全部置成负无穷,softmax 之后这些位置权重归零。这层遮挡叫因果掩码(causal mask)。
热图上它的痕迹一目了然:合法注意力只存在于左下三角。下面的实验台有个「偷看未来」开关,把被因果掩码盖住的上三角「禁区」用灰色斜纹亮出来——合法区和禁区并排画在同一张热图上,你自己看界线。
05热图怎么读
注意力热图是本课程最常用的仪器,你得先学会读它:行是 query(谁在看),列是 key(看谁),颜色越深权重越大(画法沿袭 bertviz)。三条读图常识:对角线几乎总是亮的——自己跟自己最相关;第一列常亮——第 6 课专门讲这个「attention sink」现象;真正有信息量的是那些跳开的深色格——比如「它」那一行在「猫」的位置突然深下去。看到了吗?指代消解,被你当场抓获。
06pythia 的账
最后对个账。pythia-14m 有 6 层,每层 4 个注意力头,每头 32 维。层与层之间、头与头之间看到的模式各不相同:浅层多看局部邻居,深层出现长距离跳跃。6×4 一共 24 张真热图可看,全部来自真权重的前向拦截——不是示意图,是你亲手可查的真值。那么问题来了:为什么要拆成 4 个「头」?下一课就讲这个。
交互实验:单头注意力显微镜
引擎加载中…
内置 3 个英文例句(含指代句,可改写),选层选头看真值热图(canvas 整幅绘制);点任意格查该 (query, key) 对 softmax 后的真实分数,并在 token 条上画出 query→key 连线;「偷看未来」开关把被因果掩码遮住的上三角画成灰色斜纹做对照。
等待开始下载…
组件挂载点 · 单头注意力显微镜将在下一波接入(复用已加载权重)
组件加载失败。
处理方式:多为网络抖动或权重文件缺失——刷新页面,或在实验台里点「重试:下载并加载 pythia-14m 权重」。图文正文不受影响。